 International Web Association Italia
Le tabelle dati numeriche si trovano un po’ dovunque: nelle pubblicazioni scientifiche ed economiche, nei prospetti di mutui e investimenti, nei libri di testo scolastici e universitari, etc.
Sono artefatti che hanno una lunga storia e la maniera di scriverle e rappresentarle è stata fortemente influenzata dalla necessità di dovere sfruttare al meglio il poco spazio presente nei formati usati per la stampa di libri, riviste, lettere e resoconti.
Una occorrenza molto comune in questo tipo di tabelle è la rappresentazione di relazioni gerarchiche tra le righe dati espressa per indentazione delle corrispondenti intestazioni di riga. Si tratta di un caso non previsto nell’attuale standard HTML e per il quale, di conseguenza, non esiste una codifica standard.
In questo articolo mostreremo una soluzione da noi trovata che permette di esporre la presenza di queste relazioni padre-figlio a chi legge la tabella con un lettore di schermo.
Cosa intendiamo per tabelle dati numeriche?
Per tabelle dati numeriche intendiamo tabelle che presentano dati numerici.
In questo tipo di tabelle, la testata, contenente le intestazioni delle colonne, occupa la prima o le prime righe. Le celle dati (corpo della tabella) occupano le righe successive, con l’intestazione di ciascuna riga posta nella prima colonna.
La caratteristica chiave di una tabella numerica è, infatti, quella di essere una griglia bidimensionale di numeri dove ciascuna cella dati contiene un valore il cui significato è dato dalle intestazioni di colonna e di riga che ne fanno da coordinate. La parte “importante” della tabella è la griglia bidimensionale che contiene i numeri. Le celle con le intestazioni di riga e di colonna servono soltanto a etichettare le celle dati e a chiarire a cosa si riferisce il numero contenuto in esse.
Descrizioni più accurate del formato di queste tabelle possono essere reperite facilmente in rete. Ad esempio:
- Tables, Figures and Equations (IEEE style) Purdue University
- Table setup (American Psychological Association)
- Design better tables
- Australian Government Style Manual (Tables)
- ISTAT – Manuale per la preparazione di originali “ready to print” (sezione 1.3 – tavole statistiche)
Tabelle numeriche semplici e complesse
Possiamo classificare le tabelle numeriche in semplici e complesse.
Per tabella numerica semplice intenderemo una tabella dove:
- La testata è costituita da una sola riga
- il corpo è costituito da un singolo gruppo di righe (righe dati)
- le intestazioni di riga delle righe dati si trovano sulla prima colonna
- non esistono relazioni gerarchiche fra le righe del corpo
Definiremo quindi complesse quelle tabelle che presentano una o più delle seguenti caratteristiche:
- presenza di relazioni gerarchiche tra le righe dati (relazioni padre-figlio)
- testata disposta su più righe (intestazioni gerarchiche di colonna)
- presenza di gruppi multipli di righe
Lo standard W3C copre molto bene il caso delle tabelle numeriche semplici, che chiama “tabelle con due intestazioni”. Anche il supporto da parte delle tecnologie assistive per la soluzione delle “due intestazioni” è eccellente. Di conseguenza, per rendere perfettamente accessibile una tabella numerica semplice in HTML basta codificarla opportunamente (cosa che, per inciso, non è quello che accade quando la si esporta da Word).
Il caso delle tabelle complesse è invece più complicato: lo standard W3C copre alcuni formati ma non tutti. Inoltre, il supporto da parte dei lettori di schermo per le codifiche proposte dal W3C per questi casi non solo è al momento estremamente variabile da un prodotto all’altro – se non da una versione all’altra dello stesso prodotto – ma, spesso, è del tutto assente.
Esistono, infine, i casi non coperti dallo standard come, ad esempio, quello di cui ci occuperemo in questo articolo.

Fonte ISTAT, https://www.istat.it/wp-content/uploads/2026/07/FLASH_2026q2.pdf

Fonte Banca d’Italia, https://www.bancaditalia.it/pubblicazioni/economie-regionali/2024/2024-0009/2409-toscana.pdf
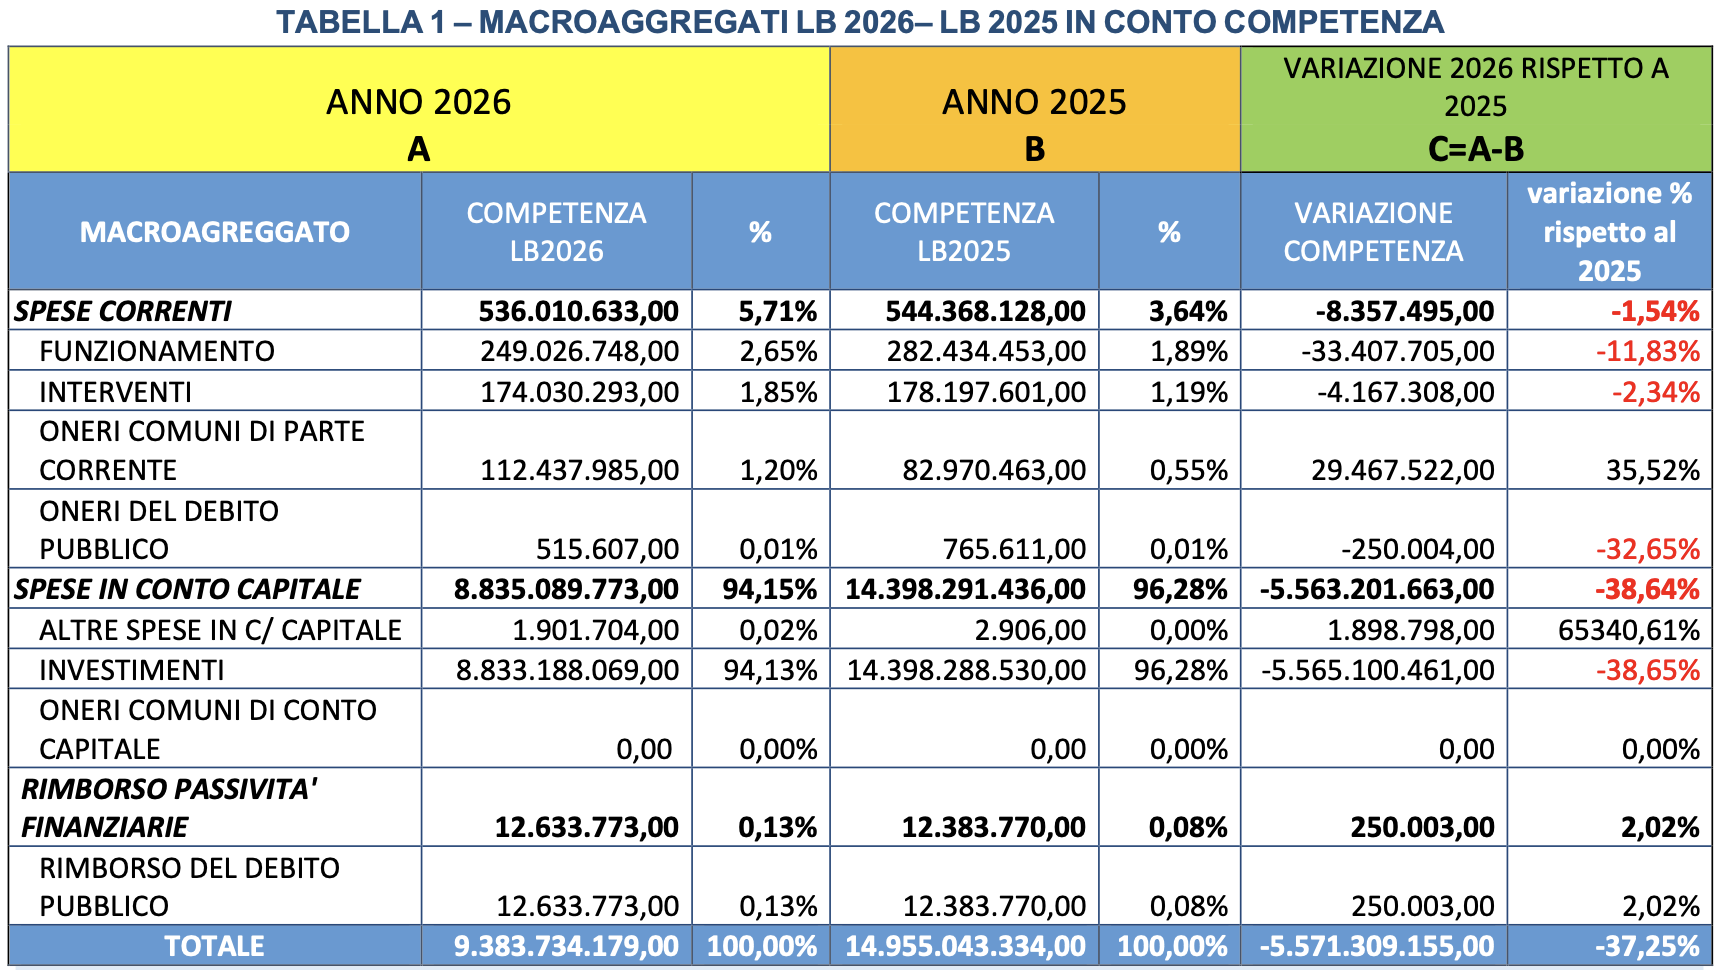
Fonte MIMIT, https://www.mimit.gov.it/images/stories/trasparenza/2026/TABELLE_BILANCIO_2026.pdf

Fonte Banca d’Italia, https://www.bancaditalia.it/pubblicazioni/economie-regionali/2024/2024-0009/2409-toscana.pdf
Codifica delle tabelle in HTML
Iniziamo intanto con l’esaminare cosa offre lo standard W3C per rappresentare una tabella dati in HTML. Adopereremo, ovviamente, un approccio semantico.
L’elemento “table”
L’elemento da usare per rappresentare una tabella dati in HTML è, naturalmente, l’elemento table. È un elemento riconosciuto dai lettori di schermo che ne annunciano la presenza indicando il numero di righe e di colonne.
L’elemento “caption”
Per dare un titolo alla tabella, o per descriverne il contenuto, è possibile usare l’elemento caption.
Contrariamente a quanto spesso si pensi, non è un elemento obbligatorio ma, se presente, deve essere il primo elemento figlio dell’elemento table.
Quando presente, il contenuto dell’elemento caption è riconosciuto dai lettori di schermo e viene letto all’inizio della tabella.
Tutte le tabelle dati necessitano di un titolo ma non deve essere necessariamente codificato tramite l’elemento caption. Ad esempio, questo è il caso che si verifica quando la tabella è all’interno di una figura ed è la figura a fornire il titolo.
Gli elementi “colgroup” e “col”
Lo standard HTML prevede la possibilità di annotare la presenza di gruppi di colonne tramite gli elementi colgroup e col.
Se presenti devono essere posti all’inizio della tabella, prima di qualsiasi elemento thead, tbody, tfoot o tr (ma dopo l’elemento caption).
Purtroppo, non è previsto che si possa nidificare un elemento colgroup dentro un altro elemento colgroup. Questo rende pertanto impossibile usarli per descrivere la struttura colonnare di tabelle complesse dove la testata si estende su più di due righe (cosa abbastanza frequente).
Gli elementi colgroup e col sono ignorati dai lettori di schermo.
Nell’esperienza degli autori, il loro uso può essere utile per semplificare l’applicazione di determinate formattazioni visuali ma la loro presenza non contribuisce in alcuna maniera all’accessibilità della tabella.
Gli elementi “tbody”, “thead” e “tfoot”
Gli elementi tbody, thead e tfoot permettono di indicare in quali e quante regioni sia suddivisa una tabella dati. Tramite il loro utilizzo possiamo indicare la presenza e l’estensione della testata, la presenza e l’estensione di ciascun gruppo di righe dati e la presenza, o meno, di un footer della tabella. Potremmo quindi considerarli alla stregua delle regioni landmark della specifica ARIA applicate alla singola tabella.
Nei test condotti dagli autori, la presenza di questi elementi non è mai stata annunciata in alcun modo dai lettori di schermo utilizzati. Cosa d’altronde rilevata anche da altri autori sia nel caso di JAWS sia nel caso di NVDA.
Nonostante ciò, nell’esperienza degli autori, oltre ad essere essenziali nell’ottica di un approccio semantico, il loro utilizzo per annotare la macrostruttura della tabella è assolutamente indispensabile se si vuole intervenire programmaticamente sulla tabella in maniera efficiente e affidabile.
Per questa ragione la nostra raccomandazione è di utilizzarli sempre per la rappresentazione di tabelle dati numeriche in HTML, anche nel caso delle tabelle semplici.
L’elemento “tr”
È usato per rappresentare le righe della tabella. In una tabella numerica codificata con un approccio semantico le righe non possono essere figlie dirette dell’elemento table ma devono invece essere figlie di uno degli elementi thead, tbody o tfoot in cui la tabella è suddivisa.
Gli elementi “th” e “td”
Gli elementi th e td sono usati per rappresentare le singole celle della tabella. Devono necessariamente essere figli di un elemento tr.
Gli elementi td sono usati per le celle dati (anche quando il dato è mancante). Le celle di intestazione, che siano di colonna o che siano di riga, devono invece essere codificate come elementi th.
Per indicare se un elemento th contiene una intestazione di riga o una intestazione di colonna si usa l’attributo scope dell’elemento: scope=”row” indica che l’intestazione è di riga, scope=”col” indica invece che l’intestazione è di colonna.
Oltre ai valori row e col l’attributo può anche assumere i valori colgroup e rowgroup. Tuttavia, nei test condotti dagli autori, questi valori sono stati trattati dai lettori di schermo testati come se fossero sinonimi dei valori col e row.
Per far sì che una cella si estenda su più colonne o su più righe si usano gli attributi colspan e rowspan, il cui valore deve corrispondere al numero di colonne o di righe che la cella occupa.
Nei test condotti dagli autori, la presenza di celle contenenti intestazione di colonna che si estendono su più righe è spesso risultata problematica per i lettori di schermo, causando la perdita della corretta associazione fra le celle dati e le intestazioni di colonna.
Per questa ragione, nella conversione in HTML di tali tabelle, le intestazioni di colonna in rowspan sono state riportate nell’ultima riga della testata (eliminando quindi l’attributo rowspan) e sono state generate le celle “mancanti” delle righe soprastanti come elementi th vuoti.
Un esempio
Riassumendo, ecco come seguendo l’approccio descritto sopra può essere rappresentata in HTML la tabella della Figura 1:
  <table>
    <thead>
    <tr>
      <th scope="col">TRIMESTRI</th>
      <th scope="col">Valori concatenati anno di riferimento 2020</th>
      <th scope="col">Valori percentuali congiunturali</th>
      <th scope="col">Valori percentuali tendenziali</th>
    </tr>
    </thead>
    <tbody>
    <tr>
      <th scope="row">2022 - I</th>
      <td>470965</td>
      <td>+0,7</td>
      <td>+7,4</td>
    </tr>
    <tr>
      <th scope="row">2022 - II</th>
      <td>478302</td>
      <td>+1,6</td>
      <td>+6,4</td>
    </tr>
    <!-- altre righe omesse -->
    </tbody>
  </table>
La grande differenza per chi usa un lettore di schermo è data dalla presenza delle intestazioni codificate come elementi th. Infatti, per chi usa NVDA o JAWS, a differenza di quello che avviene quando tutte le celle vengono codificate con elementi td, le appropriate intestazioni di riga e colonna vengono ora automaticamente lette subito prima delle celle dati mentre ci si sposta con i comandi per la navigazione bidimensionale delle tabelle (ad esempio: ctrl+alt+tasti freccia sotto Jaws); questo comportamento rende l’esperienza di lettura molto fluida.
Quanto comune è il caso della presenza di relazioni gerarchiche fra le righe e qual è il suo impatto reale?
Ci si potrebbe chiedere a questo punto: quanto comuni sono i casi di tabelle numeriche complesse rispetto a quelli di tabelle semplici? E, in particolare, quanto comune è il caso delle relazioni gerarchiche fra le righe dati espresso per indentazione dell’intestazione nella prima colonna che, come abbiamo detto, non è coperto né dallo standard W3C né supportato dai lettori di schermo?
La risposta, ovviamente, dipende dal contesto e dal tipo di pubblicazione che stiamo considerando.
Prendiamo, ad esempio, un report di analisi economica quale il rapporto annuale sull’economia della Toscana, numero 9 giugno 2024, pubblicato dalla Banca d’Italia. Nell’appendice statistica del report ci sono 64 tabelle numeriche. Di queste, 3 sono tabelle semplici e le rimanenti 61 sono tabelle complesse: 47 tabelle, infatti, hanno una testata che si estende su due o più righe, 29 contengono gruppi multipli di righe e in 28 tabelle sono presenti relazioni gerarchiche fra le righe dati espresse per indentazione delle intestazioni nella prima colonna.
Per valutare l’impatto osserviamo la Figura 5. Anche assumendo che le intestazioni di riga nella prima colonna vengano espresse correttamente in HTML come elementi th, mancando un meccanismo che segnali la relazione gerarchica è impossibile, per chi sta leggendo mediante un lettore di schermo, percepire che la seconda e la terza riga dati siano sottovoci della prima, con conseguente perdita di significato dei dati corrispondenti (come d’altronde accadrebbe per un vedente se le righe non fossero indentate).

Fonte Banca d’Italia, https://www.bancaditalia.it/pubblicazioni/economie-regionali/2024/2024-0009/2409-toscana.pdf)
L’abbondanza di tabelle complesse con uso frequentissimo dell’indentazione per segnalare la presenza di relazioni gerarchiche si può osservare anche nel Documento di finanza pubblica, Sezione II – Analisi e tendenze della finanza (2026) del Ministero dell’Economia e delle Finanze.
Si può qui vedere che la presenza di relazioni gerarchiche fra le righe non è sempre espressa per indentazione. Ad esempio, le tabelle I.3-1 e II.2-1 del sopracitato Documento di finanza pubblica usano invece l’alternanza di grassetto e corsivo.
Anche in questo caso, mancando un meccanismo che segnali esplicitamente a un lettore di schermo la presenza di una relazione gerarchica, questa potrebbe non essere colta da parte di una persona non esperta della materia che stia usando un lettore di schermo per leggere la tabella.
Esprimere le relazioni gerarchiche fra le righe dati: una possibile soluzione
Le figure che abbiamo mostrato sinora raffigurano tabelle presenti in documenti PDF spesso prodotti a partire da originali Word.
Una delle ragioni per cui raramente le tabelle complesse sono rappresentate in HTML è, infatti, la difficoltà di riprodurre in HTML le formattazioni visuali utilizzate altrove.
L’uso delle indentazioni non fa eccezione. Lo standard W3C prevede che gli spazi presenti all’inizio delle celle vengano rimossi durante la fase di rendering. Di conseguenza, in HTML, la gestione delle indentazioni tramite l’uso di spazi è essenzialmente impraticabile. Inoltre, anche trovando il modo di preservare tali spazi si avrebbe il problema dell’accessibilità perché gli spazi all’inizio della cella sono ignorati dalla totalità dei lettori di schermo.
È bene ricordare a questo punto che la presenza di una informazione presentata visualmente ma non determinabile programmaticamente o non disponibile nel testo costituisce una violazione del criterio 1.3.1, Info and relationships (Level A), delle WCAG.
Cosa possiamo quindi fare?
Partiamo dalla parte visuale. Per indentare l’intestazione di riga nella prima colonna, invece di inserire a mano spazi, possiamo usare un attributo custom sulla riga (l’elemento tr) che ci permetta di annotare il suo livello gerarchico.
Per venire incontro a chi fa il lavoro di redazione, che non necessariamente è molto esperto in materia di HTML o di tabelle numeriche, chiameremo questo attributo data-indent-level (in modo che gli ricordi che lo può usare per indentare le righe) e stabiliremo che il suo valore sia un numero positivo che corrisponde, appunto, al livello di indentazione visuale che si vuole ottenere.
Per indentare visualmente le righe basterà quindi definire le opportune regole nel foglio di stile associato. Ad esempio:
    tbody {

        tr[data-indent-level="1"] th:first-child {
            padding-left: .75rem;
        }

        tr[data-indent-level="2"] th:first-child {
            padding-left: 1.5rem;
        }

        tr[data-indent-level="3"] th:first-child {
            padding-left: 2.25rem;
        }

        tr[data-indent-level="4"] th:first-child {
            padding-left: 3rem;
        }

        tr[data-indent-level="5"] th:first-child {
            padding-left: 3.75rem;
        }

        tr[data-indent-level="6"] th:first-child {
            padding-left: 4.5rem;
        }

    }
Sebbene il nostro redattore abbia usato l’attributo per indentare visualmente le righe, la conseguenza dell’aver annotato il livello di indentazione delle righe – cioè il loro livello gerarchico – è che diventa ora possibile ricostruire in maniera programmatica l’intera gerarchia.
Questo perché il genitore di una riga con data-indent-level maggiore di zero è la prima riga che incontriamo, percorrendo all’indietro l’elenco delle righe dello stesso elemento tbody, il cui attributo data-indent-level ha un valore inferiore a quello della riga di partenza o dove l’attributo data-indent-level è assente.
Per esporre la gerarchia ai lettori di schermo possiamo quindi intercettare il caricamento della pagina nel browser dell’utente – ad esempio usando jQuery – e riscrivere al volo opportunamente le intestazioni di riga per il lettore di schermo.
Che cosa intendiamo per “riscrivere opportunamente le intestazioni”?
Facciamo un passo indietro. Come detto nell’introduzione, la maniera di scrivere le tabelle numeriche è stata fortemente influenzata dalla necessità di sfruttare al meglio il poco spazio presente nei formati usati per la stampa di libri, lettere e resoconti.
Indentare le righe per esprimere le loro relazioni gerarchiche è appunto uno dei tanti espedienti visuali che sono nati per questa ragione. L’uso dell’indentazione permette, infatti, sia di aumentare la quantità di dati mostrata a parità di spazio disponibile, sia aiuta – chi vede – a percepire la presenza di relazioni gerarchiche fra le righe dati.
La cosa importante di una tabella numerica, però, non sono le intestazioni, sono i dati. E quello che serve, mentre si leggono i dati tramite lettore di schermo, è che questi vengano associati alle intestazioni che li descrivono compiutamente.
Prendiamo ad esempio la Tavola a5.5 delle Economie regionali, Toscana, riportata nella Figura 6. Assumiamo di star leggendo, tramite lettore di schermo, i dati della seconda colonna.
Nel passaggio tra la terza e la quarta riga dati non vogliamo che ci venga letto semplicemente “Imprese” ma vogliamo che la cella sia pienamente qualificata come “Settore privato non finanziario, Imprese”. Se non viene letta anche l’intestazione della riga genitrice diventa, infatti, impossibile percepire che la riga “Imprese” sia una sottovoce di “Settore privato non finanziario”.
Per la stessa ragione, all’arrivo sulla cella dati dell’ottava riga è necessario che ci venga letto “Settore privato non finanziario, Famiglie consumatrici” e non semplicemente “Famiglie consumatrici”. Perché altrimenti diventa impossibile sia percepire che quella riga è anch’essa figlia della riga 3, “Settore privato non finanziario”, sia escludere che sia sorella della riga che la precede e la cui intestazione, non processata, è “di cui: famiglie produttrici”.

Fonte Banca d’Italia, https://www.bancaditalia.it/pubblicazioni/economie-regionali/2024/2024-0009/2409-toscana.pdf)
Sulla base di queste considerazioni possiamo quindi formulare il seguente procedimento per la produzione della versione estesa delle intestazioni di riga da fornire al lettore di schermo nel caso di righe dotate di attributo data-indent-level:
- Generare il testo completo di ciascuna intestazione concatenando le intestazioni delle righe gerarchicamente superiori (ancestors) con quella della cella corrente
- Nascondere alle tecnologie assistive il testo originale dell’intestazione racchiudendolo in un elemento <span aria-hidden=”true”>
- Iniettare nella cella corrente il testo costruito nel passaggio #1 all’interno di un elemento span posizionato fuori schermo – o comunque non visibile – ma riconoscibile dalle tecnologie assistive
Quello che l’algoritmo fa, in sintesi, è nascondere al lettore di schermo l’intestazione originale della riga – facendola però rimanere visibile esattamente come prima – generando allo stesso tempo, per il solo lettore di schermo, la versione estesa dell’intestazione che comprende le intestazioni di tutte le celle antenate.
L’aspetto della tabella non cambia (e d’altronde il nostro redattore altrimenti non sarebbe motivato a inserire le annotazioni). La maniera in cui viene letta dalle tecnologie assistive invece si.
Vediamo qui un esempio in codice. Questo è il sorgente che arriva al browser:
        <tr>
            <th scope="row">
                Settore privato non finanziario
            </th>
        </tr>
        <tr data-indent-level="1">
            <th scope="row">
                Imprese
            </th>
        </tr>
        <tr data-indent-level="2">
            <th scope="row">
                medio-grandi
            </th>
        </tr>
Questo è come quel codice viene trasformato al caricamento della pagina:
    <tr>
        <th scope="row">
            Settore privato non finanziario
        </th>
    </tr>
    <tr data-indent-level="1">
        <th scope="row">
            <span aria-hidden="true">Imprese</span>
            <span class="sr-only">Settore privato non finanziario, Imprese</span>
        </th>
    </tr>
    <tr data-indent-level="2">
        <th scope="row">
            <span aria-hidden="true">medio-grandi</span>
            <span class="sr-only">Settore privato non finanziario, Imprese,
               medio-grandi</span>
        </th>
    </tr>
Per concludere, nella Figura 7 è riprodotta la Tavola a5.5, convertita in HTML e stilata opportunamente. Confrontandola con l’originale in Figura 6, si può osservare come il layout originale della tabella PDF sia stato mantenuto nella versione HTML.

Fonte Renato Mancuso, https://renatomancuso.com/ad2026/appendice_statistica/
È importante notare che la soluzione descritta può essere utilizzata per comunicare la presenza di relazioni gerarchiche fra le righe dati anche quando non viene utilizzata l’indentazione ma si ricorre ad altri espedienti visuali quale, ad esempio, l’utilizzo di righe in grassetto e righe in corsivo visto nel precedentemente citato Documento di finanza pubblica del MEF. Essendo infatti l’aspetto visuale determinato dal foglio di stile, basterà ridefinire opportunamente le corrispondenti regole CSS.
Per chi vuole esaminare più in dettaglio la soluzione descritta, la conversione in HTML dell’intera appendice statistica del rapporto annuale sull’economia della Toscana, numero 9 giugno 2024, citato in precedenza, è disponibile al seguente indirizzo:
https://renatomancuso.com/ad2026/appendice_statistica/
Ringraziamenti
Gli autori desiderano ringraziare Paolo Leonardi e Alessandro Baldi, co-autori insieme a noi delle soluzioni descritte nell’articolo, e WebAccessibile.org per aver avuto fiducia in noi. Grazie!