 International Web Association Italia

Nel lavoro di sviluppo e di remediation si ripresenta puntuale una scorciatoia: la ricerca della soluzione a catalogo. Di fronte a una non conformità emersa in audit, o alla necessità di rendere accessibile un’interazione, si individua un pattern collaudato, se ne preleva lo snippet e lo si applica. Dietro questa prassi c’è un assunto: se il codice è sintatticamente e semanticamente corretto, il risultato sarà accessibile.
Non è così. Una soluzione formalmente impeccabile può rivelarsi inadatta, controproducente o disorientante se separata dallo scopo reale dell’interfaccia. Oggi questa scorciatoia ha un nuovo alleato, l’intelligenza artificiale generativa, e con esso un rischio più sottile: che a essere delegata non sia più soltanto l’esecuzione, ma la decisione.
Due modi di non decidere
Alla tendenza a standardizzare le risposte tecniche contribuiscono due spinte. La prima è l’abitudine, il «si è sempre fatto così», che porta a replicare vecchie implementazioni per inerzia. La seconda è l’affidamento all’IA per individuare correzioni o generare componenti accessibili.
Le due modalità hanno una debolezza in comune: la risposta nasce da una base statistica, non da una valutazione del caso specifico. Un modello linguistico restituisce la composizione più probabile, e il web su cui si è formato è saturo di implementazioni ridondanti, markup approssimativo e abuso di WAI-ARIA. Lavoro da anni in progetti di accessibilità e remediation su grandi piattaforme, in ambito bancario, assicurativo e della grande distribuzione, e lo vedo ogni giorno: ruoli ridondanti, attributi che contraddicono la semantica nativa, componenti complessi dove sarebbe bastato un elemento HTML. L’output generato tende a riproporre le prassi più diffuse, anche quando sono inopportune per il contesto.
Il primo nodo: la delega della decisione
A questo punto l’obiezione è immediata: se descrivo bene il contesto nel prompt (scopo del form, tipo di utente, flusso applicativo), l’IA saprà darmi la soluzione giusta?
Spesso può farlo, e non è questo il punto. Un modello, se alimentato con informazioni adeguate, può confrontare alternative, adattare un pattern e motivare una scelta. Il problema sta a monte: per scrivere quel prompt qualcuno deve aver già deciso quale sia lo scopo dell’elemento, quale esperienza si voglia offrire e quale carico cognitivo sia ragionevole chiedere a chi usa la pagina. Questa è l’intenzionalità progettuale, ed è una decisione, non un calcolo.
Il rischio concreto, che si osserva sempre più spesso, è che progettisti, sviluppatori e decisori ritengano che il cerchio si chiuda proprio qui: che sia l’IA a compiere anche questa scelta. Si chiede alla macchina «come rendo accessibile questo componente?», senza essersi chiesti prima se quel componente sia necessario, se sia lo strumento giusto per quel compito e per quelle persone. La risposta arriva, è plausibile, ben formattata e conforme. E proprio per questo viene accettata senza che nessuno si sia assunto la responsabilità di decidere.
Non è un limite che si superi con modelli più potenti. Anche con una capacità di analisi illimitata, nessun sistema può assumersi la responsabilità di uno scopo che nessuno ha definito. Può soltanto restituire la scelta più frequente, presentandola come risposta.
Il secondo nodo: la valutazione a valle
Saper decidere e formulare un buon prompt, però, non basta. Serve anche essere in grado di valutare ciò che l’IA restituisce. Chi non ha le competenze per giudicare il risultato non può nemmeno sapere se il prompt di partenza fosse quello giusto, e finisce per accettare a scatola chiusa un prodotto di cui non conosce il funzionamento né le conseguenze.
Il punto è delicato perché l’output generato è, quasi sempre, ordinato, plausibile e valido. L’errore non sta nella sintassi ma nell’adeguatezza al caso, e nessuno strumento automatico può giudicarla. Gli assessment automatici, anche nell’epoca dell’IA, restano del tutto insufficienti: coprono solo una parte limitata dei problemi, talvolta sono inutili, talvolta producono falsi positivi. Per riconoscere l’errore occorre la stessa competenza che serviva per decidere. Decidere a monte e valutare a valle sono due facce della stessa responsabilità: nessuna delle due può essere affidata a un automatismo.
L’equivoco dell’APG: da laboratorio didattico a repertorio di snippet
L’illusione di un serbatoio universale di soluzioni pronte trova la sua espressione più evidente nel modo in cui viene usato il W3C ARIA Authoring Practices Guide (APG). Nato come guida e laboratorio per comprendere l’applicazione degli attributi ARIA, è stato progressivamente scambiato per un catalogo di componenti da incollare in produzione. Lo fanno sviluppatori e consulenti e, di riflesso, i modelli di IA che si addestrano sul web.
È un errore sostanziale, e le sue conseguenze sono spesso pesanti. Lo stesso APG chiarisce, in una sezione introduttiva regolarmente ignorata e intitolata Read Me First, che i suoi esempi non sono una libreria pronta per il rilascio, ma materiale didattico per esplorare specifiche interazioni in contesti isolati. Nei progetti in cui intervengo lo vedo con regolarità: componenti presi dall’APG e portati in produzione così come sono, senza chiedersi se servissero.
Calare un pattern complesso nato in laboratorio dentro un’applicazione reale, magari al posto di un elemento HTML nativo che svolgeva egregiamente lo stesso compito, non è fare accessibilità. L’IA, assimilando questa mole di esempi decontestualizzati, li restituisce come regola, e l’esempio didattico diventa prescrizione: un circolo vizioso.
Un caso concreto: la data in un modulo
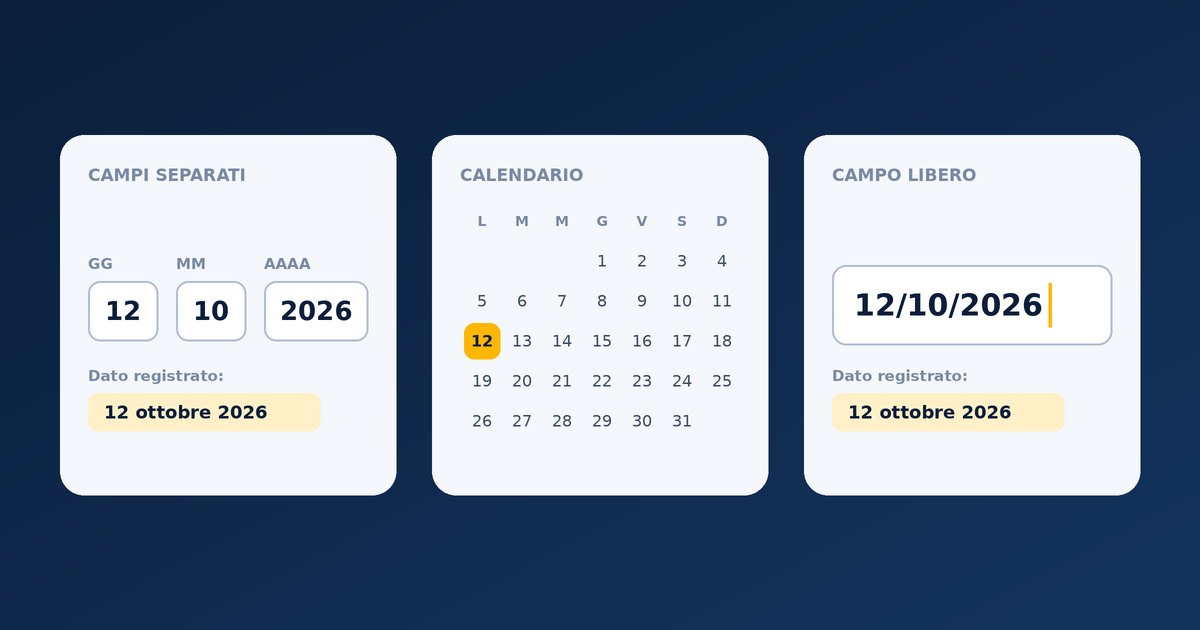
Un caso apparentemente banale, l’acquisizione di una data, mostra come soluzioni molto diverse possano essere tutte conformi alle WCAG e come solo la comprensione dello scopo renda una scelta appropriata.
Data già nota all’utente (la propria data di nascita, il rilascio di un documento). Conta la rapidità di digitazione. La scelta corretta è, di norma, usare campi distinti per giorno, mese e anno, oppure un campo testuale con istruzioni e formato espliciti. Qui un date picker è una penalizzazione: chi naviga da tastiera o con screen reader deve risalire decenni attraverso una griglia mensile, per quanto il widget sia accessibile secondo le specifiche.
In questo scenario entra anche l’attributo autocomplete, ed è un buon esempio di come un suggerimento tecnico vada capito prima di essere applicato. I valori come bday-day, bday-month e bday-year (criterio 1.3.5) non sono comandi assoluti: sono indicazioni che il browser può onorare, in base a quanto ha memorizzato e riutilizza. E hanno senso solo se il campo riguarda l’utente stesso. Sono invece frequentissimi nei moduli dove non servono, per esempio quando si deve inserire la data di nascita di un familiare. Il markup è valido, l’attributo è ben formato e un’IA lo proporrebbe con piena sicurezza. Il risultato è formalmente corretto e funzionalmente sbagliato, e solo chi sa valutare lo vede.
Prenotazione di un soggiorno o acquisto di un biglietto. L’utente deve orientarsi tra giorni della settimana, ponti e festività, e selezionare un intervallo. Qui la griglia di un date picker ben realizzato con WAI-ARIA è il supporto che aiuta a ragionare sul tempo. Anche la griglia, però, ha un costo che nessuna verifica di conformità misura: in un calendario mensile organizzato per settimane, giorni consecutivi possono trovarsi agli estremi opposti di una riga, mentre giorni distanti restano incolonnati uno sopra l’altro. È un meccanismo che può indurre in errore chi legge, pur in uno schema perfettamente accessibile.
Contesti ad alta mobilità. L’elemento nativo <input type="date"> può essere l’opzione migliore, perché sfrutta i controlli ottimizzati del sistema operativo. Va però verificato, perché supporto e comportamento con le tecnologie assistive variano tra browser e piattaforme: nemmeno il nativo è una risposta valida sempre.
Applicazioni di gestione attività. Un campo a testo libero interpretato da logiche di parsing può offrire la massima efficienza, a patto di restituire un feedback immediato e chiaro sul valore registrato.
Come per l’agenda cartacea, che si sceglie in base a come si lavora (un giorno per pagina, la settimana su due facciate, il planning mensile), il formato giusto dipende dall’uso. Non esiste un componente accessibile perfetto in assoluto. Nessun catalogo e nessuna risposta statistica possono indicare l’opzione adatta senza che qualcuno abbia stabilito a che cosa serve quel dato, qual è il modello mentale di chi lo inserisce e dove si colloca nel flusso.
La tecnica si automatizza, la scelta si governa
Gli automatismi, IA compresa, possono accelerare molte attività: generare una bozza, individuare un’incongruenza, proporre alternative da valutare. Non hanno però la visione d’insieme né la responsabilità dell’esperienza che ricade sulle persone, in particolare su quelle con disabilità.
Il rischio maggiore non sta nello strumento, ma nel considerarlo un sostituto di chi decide e di chi valuta. L’accessibilità non si ottiene applicando una correzione per analogia statistica: si ottiene valutando il contesto d’uso, comprendendo le esigenze delle persone, scegliendo consapevolmente e verificando con competenza ciò che si è scelto. Decidere a monte, valutare a valle: due responsabilità che nessun automatismo può sostituire.
